

@OneToMany & @ManyToOne trong JPA
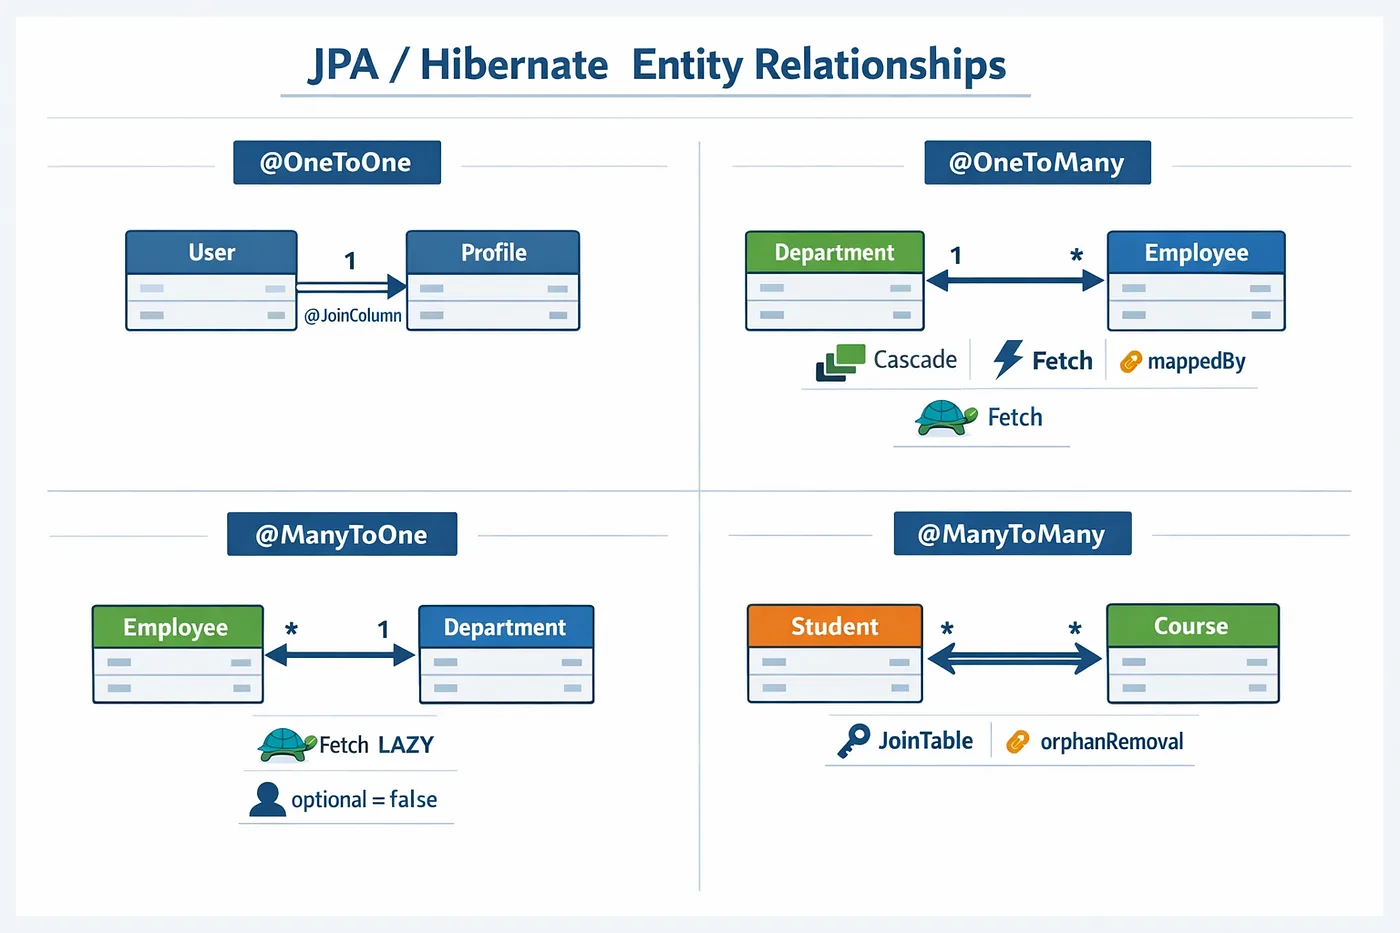
- Published on
- /10 mins read/
Trong các ứng dụng doanh nghiệp sử dụng Spring Data JPA và Hibernate, mối quan hệ Một-Nhiều (1-N) là cấu trúc dữ liệu xuất hiện thường xuyên nhất: một Khách hàng có nhiều Đơn hàng (Customer -> Orders), một Đơn hàng có nhiều Chi tiết sản phẩm (Order -> OrderItems), một Phòng ban có nhiều Nhân viên (Department -> Employees).
Tuy nhiên, đây cũng chính là nơi xuất phát của hơn 80% các sự cố sụt giảm hiệu năng database trên môi trường Production:
- API tải danh sách chậm chạp do phát sinh hàng nghìn câu truy vấn con (N+1 Query Problem).
- Server sập do tràn bộ nhớ Heap khi Hibernate load toàn bộ database vào RAM thông qua Cartesian Product Explosion.
- Ứng dụng crash với
StackOverflowErrordo vòng lặp vô tận giữatoString()vàhashCode()của Lombok. - Hibernate âm thầm tạo thêm một bảng phụ (Junction Table) không mong muốn chỉ vì thiếu thuộc tính
mappedBy.
Bài viết này sẽ phân tích toàn diện các quy tắc thiết kế chuẩn production cho cặp bài trùng @OneToMany và @ManyToOne.
# bản chất quan hệ owning side vs inverse side
Trong cơ sở dữ liệu quan hệ (RDBMS), bảng ở phía Nhiều (Many) luôn là bảng nắm giữ cột khóa ngoại (Foreign Key - FK). Phía Một (One) hoàn toàn không có cột nào trỏ tới phía Nhiều.
Trong JPA/Hibernate:
- Owning Side (Phía sở hữu quan hệ): Luôn là entity phía
@ManyToOne. Nó trực tiếp ánh xạ tới cột Foreign Key thông qua@JoinColumn(name = "parent_id"). Mọi thay đổi dữ liệu (gán parent, gỡ parent) chỉ được Hibernate flush xuống DB khi bạn thao tác trên Owning Side. - Inverse / Non-Owning Side (Phía bị sở hữu): Là entity phía
@OneToMany. Nó bắt buộc phải khai báomappedBy = "tên_thuộc_tính_ở_owning_side".
# cái bẫy quên khai báo mappedBy
Nếu bạn chỉ viết:
@OneToMany(cascade = CascadeType.ALL)
private List<Employee> employees;
Hibernate sẽ mặc định coi đây là quan hệ Unidirectional One-to-Many. Nó sẽ tự động sinh thêm một bảng trung gian department_employees (department_id, employee_id) kèm theo hàng loạt câu lệnh INSERT/DELETE thừa thãi trên bảng phụ này mỗi khi thêm/xóa phần tử!
# hiểm họa eager ngầm và n+1 query
# cạm bẫy FetchType.EAGER mặc định của @ManyToOne
Theo đặc tả JPA:
@OneToManycó fetch type mặc định làFetchType.LAZY(An toàn).@ManyToOneCÓ FETCH TYPE MẶC ĐỊNH LÀFetchType.EAGER(Vô cùng nguy hiểm!).
Khi bạn query 100 Employee, Hibernate sẽ tự động bắn thêm 100 câu query đơn lẻ để load Department của từng nhân viên đó.
WARNING
Quy Tắc Bắt Buộc: Mọi quan hệ @ManyToOne trong toàn bộ codebase doanh nghiệp PHẢI LUÔN LUÔN được khai báo tường minh là: @ManyToOne(fetch = FetchType.LAZY)!
# n+1 query problem trên @OneToMany
Khi bạn duyệt qua danh sách phòng ban và truy cập vào danh sách nhân viên:
List<Department> depts = departmentRepository.findAll(); // 1 câu query lấy N departments
for (Department dept : depts) {
    System.out.println(dept.getEmployees().size()); // Phát sinh N câu query con!
}
Tổng số câu query gửi xuống DB là 1 + N. Nếu N = 1,000, database sẽ bị quá tải ngay lập tức.
# giải pháp diệt trừ n+1
Để giải quyết triệt để N+1, Kỹ sư phần mềm có 3 sự lựa chọn tùy ngữ cảnh:
# giải pháp 1: JOIN FETCH trong jpql
Ép Hibernate thực hiện phép INNER JOIN hoặc LEFT JOIN để nạp cả Parent và Children trong một câu query duy nhất:
public interface DepartmentRepository extends JpaRepository<Department, Long> {

    @Query("SELECT DISTINCT d FROM Department d LEFT JOIN FETCH d.employees")
    List<Department> findAllWithEmployees();
}
# giải pháp 2: @EntityGraph linh hoạt
Cho phép tái sử dụng các method mặc định của Spring Data JPA (findAll, findById) mà vẫn nạp LAZY collection theo ý muốn:
public interface DepartmentRepository extends JpaRepository<Department, Long> {

    @EntityGraph(attributePaths = {"employees"})
    List<Department> findAll();
}
# giải pháp 3: @BatchSize cho phân trang
Khi bạn cần phân trang (Pagination) danh sách Parent (Pageable), việc dùng JOIN FETCH sẽ bị Hibernate cảnh báo: HHH000104: firstResult/maxResults specified with collection fetch; applying in memory! (Hibernate phải kéo toàn bộ dữ liệu về RAM để phân trang thủ công -> Nguy cơ OOM).
@BatchSize là giải pháp tối thượng cho trường hợp này:
@Entity
public class Department {
    // ...
    @OneToMany(mappedBy = "department")
    @BatchSize(size = 50) // Khi duyệt collection, Hibernate gom 50 parent IDs thành 1 câu: WHERE department_id IN (?, ?, ...)
    private Set<Employee> employees = new HashSet<>();
}
Số câu query giảm ngoạn mục từ 1 + N xuống chỉ còn 1 + ceil(N / 50) câu!
TIP
Quy tắc phân loại:
- Khi không phân trang và cần dữ liệu con ngay: Ưu tiên
@EntityGraphhoặcJOIN FETCH. - Khi có phân trang (
Pageable): Tuyệt đối không dùngJOIN FETCH, hãy dùng@BatchSize(size = 50).
# bẫy cartesian product và MultipleBagFetchException
Một lỗi rất phổ biến khi lập trình viên cố gắng fetch nhiều hơn một quan hệ 1-N cùng lúc:
// Giả sử Department có cả: List<Employee> employees VÀ List<Project> projects
@Query("SELECT d FROM Department d LEFT JOIN FETCH d.employees LEFT JOIN FETCH d.projects")
List<Department> findBadQuery(); // 🔴 CRASH: MultipleBagFetchException
# nguyên nhân gốc rễ
Nếu một department có 100 employees và 20 projects, phép tích Descartes (Cartesian Product) trên DB sẽ trả về:
100 * 20 = 2,000 dòng kết quả lặp đi lặp lại!Trong Java, java.util.List cho phép phần tử trùng lặp (được Hibernate quản lý dưới dạng PersistentBag). Hibernate từ chối chạy vì không thể xác định cách map 2,000 dòng trùng lặp này vào hai List riêng biệt mà không làm sai lệch số lượng phần tử.
# cách xử lý chuẩn mực
- Chuyển từ
ListsangSet: Sử dụngSet<Employee>vàSet<Project>. Hibernate sẽ dùng bảng băm để tự động loại bỏ các bản ghi trùng lặp sinh ra từ Cartesian Product. - Tách thành hai câu Query độc lập: Fetch
employeesở câu query 1, sau đó fetchprojectsở câu query 2 trong cùng một@Transactional. Hibernate Persistence Context (First-Level Cache) sẽ tự động liên kết các entity lại với nhau trong bộ nhớ mà không sinh ra tích Descartes.
# đồng bộ trạng thái hai chiều
Một lỗi logic tai hại là gán quan hệ ở một phía nhưng quên cập nhật phía còn lại trong bộ nhớ:
Department dept = departmentRepository.findById(1L).get();
Employee emp = new Employee();
emp.setDepartment(dept); // Chỉ set owning side!

// Lúc này, trong Hibernate First-Level Cache:
dept.getEmployees().contains(emp); // 🔴 TRẢ VỀ FALSE! Dữ liệu trong RAM bị lệch pha!
# triển khai helper methods chuẩn mực
@Entity
public class Department {
    @Id @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    private String name;

    @OneToMany(mappedBy = "department", cascade = CascadeType.ALL, orphanRemoval = true)
    private Set<Employee> employees = new HashSet<>();

    // Helper methods đảm bảo tính nhất quán 100% cho bộ nhớ RAM
    public void addEmployee(Employee employee) {
        employees.add(employee);
        employee.setDepartment(this);
    }

    public void removeEmployee(Employee employee) {
        employees.remove(employee);
        employee.setDepartment(null);
    }
}
NOTE
Thuộc tính orphanRemoval = true đảm bảo rằng khi một Employee bị gỡ khỏi danh sách department.getEmployees().remove(emp), Hibernate sẽ tự động phát sinh lệnh DELETE FROM employees WHERE id = ? xuống database.
# lombok anti-pattern và thảm họa StackOverflowError
Rất nhiều kỹ sư dùng Lombok có thói quen đặt @Data lên các JPA Entity:
@Entity
@Data // 🔴 TỬ HUYỆT CỦA JPA ENTITY!
public class Department {
    @OneToMany(mappedBy = "department")
    private Set<Employee> employees;
}

@Entity
@Data // 🔴 TỬ HUYỆT!
public class Employee {
    @ManyToOne(fetch = FetchType.LAZY)
    private Department department;
}
# tại sao @Data là cấm kỵ đối với jpa entity
- Vòng lặp đệ quy vô tận trong
toString():Department.toString()gọiEmployee.toString(), vàEmployee.toString()lại gọi ngược lạiDepartment.toString(). Kết quả:StackOverflowErrorlàm sập luồng ngay lập tức. - Phá vỡ tính bất biến trong
equals()vàhashCode():@Datatự động sinhequalsvàhashCodedựa trên toàn bộ các trường (kể cả ID). Khi một entity mới được khởi tạo (new Employee()),idcủa nó lànull. Sau khirepository.save(),idđược DB sinh ra giá trị mới (ví dụ:1L).- Sự thay đổi
hashCodesau khi persist sẽ phá hủy cấu trúc củaHashSet/HashMap, khiến bạn không thể tìm thấy entity đó trong Set dù nó vẫn tồn tại!
- Sự thay đổi
# thiết lập chuẩn cho jpa entity
@Entity
@Getter
@Setter
@NoArgsConstructor
@AllArgsConstructor
public class Employee {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    private String fullName;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "department_id")
    private Department department;

    // Chỉ dùng Khóa Nghiệp Vụ (Business Key) hoặc ID cố định cho equals/hashCode
    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (!(o instanceof Employee other)) return false;
        return id != null && id.equals(other.getId());
    }

    @Override
    public int hashCode() {
        return getClass().hashCode(); // Giá trị băm cố định bảo vệ tính nhất quán trong Set
    }
}
# tổng kết và checklist thực chiến
| Hạng mục | Quy tắc bắt buộc | Hậu quả nếu vi phạm |
|---|---|---|
| FetchType | Mọi @ManyToOne PHẢI khai báo fetch = FetchType.LAZY. | N+1 queries âm thầm làm tê liệt database. |
| Mapping | Phía @OneToMany bắt buộc phải có thuộc tính mappedBy. | Sinh thêm bảng Junction trung gian thừa thãi. |
| Data Structure | Ưu tiên dùng Set<T> thay vì List<T> cho @OneToMany. | Gặp lỗi MultipleBagFetchException khi fetch nhiều collection. |
| Pagination | Không dùng JOIN FETCH khi phân trang; hãy dùng @BatchSize. | Hibernate phải load toàn bộ bảng vào RAM để phân trang thủ công. |
| Lombok | Cấm dùng @Data trên JPA Entity; dùng @Getter, @Setter riêng biệt. | StackOverflowError và lỗi hash code trong Set. |
| Encapsulation | Luôn viết phương thức đồng bộ hai chiều (addXxx, removeXxx). | Dữ liệu trong bộ nhớ RAM không khớp với DB. |
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.
On this page
- # bản chất quan hệ owning side vs inverse side
- # cái bẫy quên khai báo mappedBy
- # hiểm họa eager ngầm và n+1 query
- # cạm bẫy FetchType.EAGER mặc định của @ManyToOne
- # n+1 query problem trên @OneToMany
- # giải pháp diệt trừ n+1
- # giải pháp 1: JOIN FETCH trong jpql
- # giải pháp 2: @EntityGraph linh hoạt
- # giải pháp 3: @BatchSize cho phân trang
- # bẫy cartesian product và MultipleBagFetchException
- # nguyên nhân gốc rễ
- # cách xử lý chuẩn mực
- # đồng bộ trạng thái hai chiều
- # triển khai helper methods chuẩn mực
- # lombok anti-pattern và thảm họa StackOverflowError
- # tại sao @Data là cấm kỵ đối với jpa entity
- # thiết lập chuẩn cho jpa entity
- # tổng kết và checklist thực chiến